合成に強い書き方を学ぶ
(1)ここで学ぶ内容
論理合成ツールはどんな記述でも最適な回路を合成してくれるというわけではありません。ここでは論理合成したときにより良い回路ができる記述を教えます。
論理合成は気難しいツールですので気を使わないといけないと思ってください。
- 記述の違いにより論理合成後の結果に良否があることを理解する
- case 文や演算子の論理合成に適した使い方を学ぶ
論理合成ツールの能力を引き出すために、回路記述における以下の留意点を理解する
- case 文における default の効用
- 複数ビット選択式の分割
- 条件演算子の多重ネスティング
- 関係演算子の使用
- 同一処理の繰り返し
- レジスタ代入の鉄則
記述の違いによる、合成結果を確認する
(2)case 文における default の効用
case 文をつかって 8to3 エンコーダを記述する二つの例を比較してみましょう。
このエンコーダの入力は 8 本あり特定の一本のみが 1 で他の 7 本は 0 になっています。出力は入力の 1 になっているビット位置に応じた値になります。
例えば入力のビット 0 が 1 で他のビットがすべて 0 のときは出力は 000 になります。またビット 3 が 1 で他のビットがすべて 0 のときは、出力は 011 になります。
入力は 8 ビットなので、そのとりうる値は 256 種類ありますが、ここではそのうちの 8 種類しか使っていません。そのほかについては最後に default を書いて対応します。default はそれ以前に記述された項目以外の項目すべてという意味です。
回路を小さくしたいなら x、動作を決めたいなら既知の値
そのときに出力される値は不定値を出力するように記述してください。論理合成ツールは出力の不定値を don't care として扱います。つまりここでは記述された 8 つの項目以外の入力がきたときは、出力は何でもよいと判断されます。論理合成はこの条件をつかって最適化できるようになります。どれだけ小さくなるかは回路と制約しだいなので、実際の効果は同じデバイス・同じ制約で合成してレポートを比べて確かめてください。
代わりに、その値を出力する回路が必要になります。どちらを選ぶかは「その入力が起こりうるか」「起きたとき決まった動きが要るか」で決めてください。x を書くと、その入力に対する安全な動作を要求できなくなります。面積や速度にどれだけ効くかは、同じデバイス・同じ制約で合成してレポートを比べないと分かりません。使っていない状態から戻れるかを実際に試す例はO3の実習、don't care の伝え方の注意はL2の補足にあります。
もふねこ:
case文を使うときは、絶対に default を書くのを忘れないでね🐾!
default で x (Don't care) を指定してあげると、ツールが「ここは適当でいいんだな」って解釈してくれて、回路が劇的に小さく・速くなることがあるんだよ。ちょっとした書き方の違いで、魔法みたいに結果が変わるから面白いよね!
✅ ENCODER_X (default に 3'bxxx を代入)
module ENCODER_X(A,Y);
input  [7:0] A;
output [2:0] Y;
reg    [2:0] Y;

always @( A )
  case ( A )
    8'b00000001 : Y <= 3'b000;
    8'b00000010 : Y <= 3'b001;
    8'b00000100 : Y <= 3'b010;
    8'b00001000 : Y <= 3'b011;
    8'b00010000 : Y <= 3'b100;
    8'b00100000 : Y <= 3'b101;
    8'b01000000 : Y <= 3'b110;
    8'b10000000 : Y <= 3'b111;
    default     : Y <= 3'bxxx;
  endcase
endmodule
❌ ENCODER_1 (default に 3'b111 を代入)
module ENCODER_1(A,Y);
input  [7:0] A;
output [2:0] Y;
reg    [2:0] Y;

always @( A )
  case ( A )
    8'b00000001 : Y <= 3'b000;
    8'b00000010 : Y <= 3'b001;
    8'b00000100 : Y <= 3'b010;
    8'b00001000 : Y <= 3'b011;
    8'b00010000 : Y <= 3'b100;
    8'b00100000 : Y <= 3'b101;
    8'b01000000 : Y <= 3'b110;
    8'b10000000 : Y <= 3'b111;
    default     : Y <= 3'b111;
  endcase
endmodule
これらの記述を論理合成し、合成後の回路図とレポートをみて結果を比較してみましょう。
ENCODER_X (default: 3'bxxx) 合成回路図の構造詳細
- 入力ポート: A[7], A[6], A[5], A[4], A[3], A[2], A[1], A[0]
- 出力ポート: Y[2], Y[1], Y[0]
- 構造的特徴: 入力信号から必要なビットのみを選択し、わずか3つのORゲート(またはNOR/NANDの等価論理)のみが並行して配置されている。非常にシンプルで無駄がなく、下の説明用レポート例では遅延(データ到着時刻)が 1.35 になっている。
ENCODER_1 (default: 3'b111) 合成回路図の構造詳細
- 構造的特徴: default時に特定の値(111)を出力する制約を満たすため、don't careの最適化が効かず、AND, OR, NOT, XORゲートなど多数のゲートが複雑に直列・並列に入り乱れる巨大な回路が生成されている。
- 影響: 下の説明用レポート例では、セル数が3から20へ、遅延が1.35から6.58へと変わっている。※これらは、この教材にもとから載っているレポート例(ライブラリ
hd350s)の値で、こちらで再現したものではないよ。ツールの版や設定一式、元の出典は確認できていない。同じ条件で合成しないと、この差がそのまま出るとは限らない。
✅ ENCODER_X 説明用レポート例
*****************************************
レポート: area
回路  : ENCODER_X
*****************************************

ポート数:          11
ネット数:          10
セル数:             3
セル種類:           1

組み合わせ回路:     9
非組み合わせ回路:   0

合計:               9


*****************************************
レポート: timing
回路  : ENCODER_X
*****************************************

ライブラリ:      hd350s
配線遅延モデル:  hd350s_05k
コンディション:  MAX567

-----------------------------------------
A[5] (in)                     0.00      0.00
Y[2] (out)                    0.00      1.35
データ到着時刻                          1.35
-----------------------------------------
❌ ENCODER_1 説明用レポート例
*****************************************
レポート: area
回路  : ENCODER_1
*****************************************

ポート数:          11
ネット数:          28
セル数:            20
セル種類:          10

組み合わせ回路:    33
非組み合わせ回路:   0

合計:              33


*****************************************
レポート: timing
回路  : ENCODER_1
*****************************************

ライブラリ:      hd350s
配線遅延モデル:  hd350s_05k
コンディション:  MAX567

-----------------------------------------
A[4] (in)                     0.00      0.00
Y[1] (out)                    0.00      6.58
データ到着時刻                          6.58
-----------------------------------------
(3)複数ビット選択式の分割
アドレスデコーダは case 文をつかって記述すると簡単に記述できます。その場合 case 文の選択式にはアドレス ADDR を使います。
しかし、論理合成ツールは選択式のビット幅が大きくなるほど論理圧縮しにくくなります。当然回路規模も大きくなります。
32 ビットアドレスデコーダ
case ( ADDR )
    32'b01000000_00000000_11110110_11100110: DOUT <= 5'b00000;
    32'b01000000_00000000_11110111_11110110: DOUT <= 5'b00010;
    32'b01000000_00000000_11010110_11100110: DOUT <= 5'b00011;
    32'b01000000_00000000_11110110_11110110: DOUT <= 5'b00100;
    32'b10000000_00000000_11100110_11100111: DOUT <= 5'b00101;
    32'b10000000_00000000_11110110_11100110: DOUT <= 5'b00110;
    ...
たとえばこの例のように選択式 ADDR のビット 29 からビット 16 までが 0 になっているときはその部分を if 文の条件式にすることで case 文を小さくすることができます。さらにビット 31 とビット 30 を条件式にして、if 文で場合分けできます。
選択式を分割した記述
if ( ADDR[29:16]==0 )
    if( ADDR[31:30]==2'b01 )
        case ( ADDR[15:0] )
            16'b11110110_11100110: DOUT <= 5'b00000;
            16'b11110111_11110110: DOUT <= 5'b00010;
            ...
        endcase
    else if ( ADDR[31:30]==2'b10 )
        case ( ADDR[15:0] )
            16'b11100110_11100111: DOUT <= 5'b00101;
            16'b11110110_11100110: DOUT <= 5'b00110;
            ...
        endcase
(4)条件演算子の多重ネスティング
8to1 セレクタを記述してみましょう。セレクタはいろいろな書き方で記述できますが、ここでは条件演算子と case 文で記述し比較してみます。
条件演算子で 8to1 セレクタを記述する場合は 7 個の条件演算子をネスティングさせて記述します。
case 文で記述したものと比較してみると、条件演算子による記述の方が記述量は少なくなりますが、論理合成した後の回路規模は大きくなります。分岐の条件が多数あるときは、case 文の方が回路規模が小さくなります。
条件演算子による記述
module SEL_COND(A,SEL,Y);
input   [7:0] A;
input   [2:0] SEL;
output        Y;

assign Y = (SEL == 3'b000) ? A[0]:
           (SEL == 3'b001) ? A[1]:
           (SEL == 3'b010) ? A[2]:
           (SEL == 3'b011) ? A[3]:
           (SEL == 3'b100) ? A[4]:
           (SEL == 3'b101) ? A[5]:
           (SEL == 3'b110) ? A[6]:
                             A[7];
endmodule
case文による記述
module SEL_CASE(A,SEL,Y);
input   [7:0] A;
input   [2:0] SEL;
output        Y;
reg           Y;

always @( A or SEL) begin
    case ( SEL )
        3'b000:     Y <= A[0];
        3'b001:     Y <= A[1];
        3'b010:     Y <= A[2];
        3'b011:     Y <= A[3];
        3'b100:     Y <= A[4];
        3'b101:     Y <= A[5];
        3'b110:     Y <= A[6];
        3'b111:     Y <= A[7];
        default:    Y <= 1'bx;
    endcase
end
endmodule
SEL_COND (条件演算子の多重ネスティング) 合成回路図の構造詳細
- 構造的特徴: 多数のマルチプレクサ(MUX)や論理ゲートが直列(カスケード)に何段も連なる構造になっている。
- 影響: 信号が左から右へ通過する際のゲート段数が深く、クリティカルパスが長くなるため、遅延時間(データ到着時刻 7.24)が大きくなっている。
SEL_CASE (case文による分岐) 合成回路図の構造詳細
- 構造的特徴: 各選択肢が並列な木構造(ツリー構造)として展開され、入力から出力までのゲート段数が浅く均等に配置されている。
- 影響: 信号が通過するゲート段数が少なくなるよう最適化されており、遅延時間(データ到着時刻 3.72)が大幅に短縮されている。
❌ SEL_COND 説明用レポート例
*****************************************
レポート: area
回路  : SEL_COND
*****************************************

ポート数:          12
ネット数:          27
セル数:            16
セル種類:           5

組み合わせ回路:    27
非組み合わせ回路:   0

合計:              27


*****************************************
レポート: timing
回路  : SEL_COND
*****************************************

ライブラリ:      hd350s
配線遅延モデル:  hd350s_05k
コンディション:  MAX567

-----------------------------------------
SEL[0] (in)                   0.00      0.00
Y (out)                       0.00      7.24
データ到着時刻                          7.24
-----------------------------------------
✅ SEL_CASE 説明用レポート例
*****************************************
レポート: area
回路  : SEL_CASE
*****************************************

ポート数:          13
ネット数:          21
セル数:            10
セル種類:           4

組み合わせ回路:    18
非組み合わせ回路:   0

合計:              18


*****************************************
レポート: timing
回路  : SEL_CASE
*****************************************

ライブラリ:      hd350s
配線遅延モデル:  hd350s_05k
コンディション:  MAX567

-----------------------------------------
SEL[0] (in)                   0.00      0.00
Y (out)                       0.00      3.72
データ到着時刻                          3.72
-----------------------------------------
(5)関係演算子の使用
信号が特定の値になっているかを判断する場合には、関係演算子を使用します。
大小比較( <,> )は回路が大きくなりやすい
出来るだけ等号( == )を使用する
reg [3:0] CNT;
always @( posedge CLK or posedge RES )
    if ( RES==1'b1 )
        CNT <= 4'h0;
    else if ( CNT>=4'h9 )
        CNT <= 4'h0;
    else
CNT <= CNT + 4'h1;CNT[3] & CNT[0] への簡略化が成立するのは、この例のようにCNTが0〜9の範囲しか取らない(10進カウンタである)ことが前提です。CNTが10以上の値を取り得る回路では、11・13・15でも条件が成立してしまうため使えません。また、ノイズ等による異常値からの復帰(フェールセーフ)を重視する現場では、回路が少し大きくなっても、あえて
>= を使う防衛的な書き方が好まれることもあります。回路規模と安全性のトレードオフとして使い分けてください。
(6)同一処理の繰り返し
wire   CLK,RES;
reg    COUT; // キャリー信号
reg    [3:0] LSB,MSB; // 1の桁、10の桁

always @(posedge CLK or posedge RES)
    if (RES == 1'b1)
        LSB <= 4'h0;
    else if (LSB == 4'h9)
        LSB <= 4'h0;
    else
        LSB <= LSB + 4'h1;

always @(posedge CLK or posedge RES)
    if (RES == 1'b1)
        MSB <= 4'h0;
    else if (LSB == 4'h9)
        if (MSB == 4'h9)
            MSB <= 4'h0;
        else
            MSB <= MSB + 4'h1;

always @(LSB or MSB)
    if (LSB == 4'h9 && MSB == 4'h9)
        COUT <= 1'b1;
    else
        COUT <= 1'b0;
wire LSB9,MSB9;
assign LSB9 = (LSB == 4'h9);
assign MSB9 = (MSB == 4'h9);wire CLK,RES;
reg COUT; // キャリー信号
reg [3:0] LSB,MSB; // 1の桁、10の桁
always @(posedge CLK or posedge RES)
if (RES == 1'b1)
LSB <= 4'h0;
else if ( LSB9 )
LSB <= 4'h0;
else
LSB <= LSB + 4'h1;
always @(posedge CLK or posedge RES)
if (RES == 1'b1)
MSB <= 4'h0;
else if ( LSB9 )
if ( MSB9 )
MSB <= 4'h0;
else
MSB <= MSB + 4'h1;
always @(LSB or MSB)
if ( LSB9 && MSB9 )
COUT <= 1'b1;
else
COUT <= 1'b0;(7)レジスタ代入の鉄則
非同期リセット付フリップフロップ
正しい記述
always @(posedge CLK or posedge RES) begin
    if (RES == 1'b1)
        Q <= 1'b0;
    else
        Q <= P;
end
不完全な記述
always @(RES) begin
    if (RES == 1'b1)
        Q <= 1'b0;
end

always @(posedge CLK) begin
    Q <= P;
end
(8)ワンポイント・アドバイス 1
合成ツールのバージョンの違いでも合成結果が変わる。
❌ ≠ ❌
(9)ワンポイント・アドバイス 2
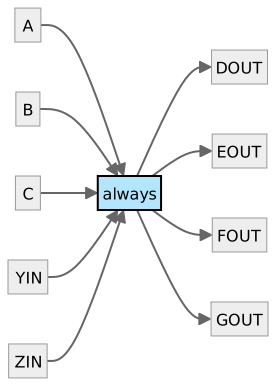
always @(A or B or C or ZIN or YIN) begin
    if (A==1'b1 && B==1'b0) begin
        DOUT <= 1'b1;
        EOUT <= ZIN;
        FOUT <= 1'b0;
        GOUT <= 1'b0;
    end else if (A==1'b0 && B==1'b0) begin
        DOUT <= 1'b0;
        EOUT <= YIN;
        FOUT <= 1'b0;
        GOUT <= 1'b0;
    end else if (A==1'b0 && B==1'b1) begin
        DOUT <= 1'b0;
        EOUT <= YIN;
        FOUT <= 1'b1;
        GOUT <= 1'b0;
    end else if (C==1'b1) begin
        DOUT <= 1'b1;
        EOUT <= ZIN;
        FOUT <= 1'b1;
        GOUT <= 1'b1;
    end else begin
        DOUT <= 1'b1;
        EOUT <= ZIN;
        FOUT <= 1'b1;
        GOUT <= 1'b0;
    end
end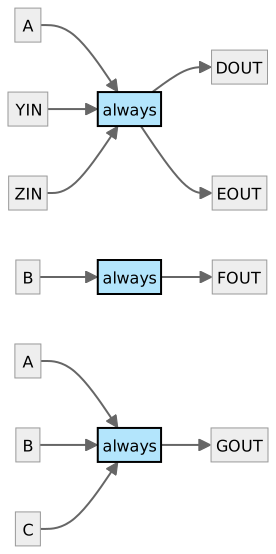
always @(A or ZIN or YIN) begin
    if (A==1'b1) begin
        DOUT <= 1'b1;
        EOUT <= ZIN;
    end else begin
        DOUT <= 1'b0;
        EOUT <= YIN;
    end
end

always @(B) begin
    if (B==1'b1)
        FOUT <= 1'b1;
    else
        FOUT <= 1'b0;
end

always @( A or B or C) begin
    if (A==1'b1 && B==1'b1 && C==1'b1)
        GOUT <= 1'b1;
    else
        GOUT <= 1'b0;
end関連の高い入出力信号はひとつの always 文にする
(10)修了判定
以下の仕様で書かれた 2 つの記述を論理合成すると、回路規模が小さくなるのはどちらか?
合成ツールを立ち上げて、論理合成する。
記述の内容を確認し、回路構造を確かめる。
LAMP サイコロカウンタ
- 入力信号: CLK, RES, EN
- 出力信号: LAMP
- EN=1 の時、サイコロ回転
- EN=0 の時、サイコロ停止
- RES=1 の時、リセット( 1の目を表示 )
LAMP[3]
| 表示 | LAMP 6 5 4 3 2 1 0 | 表示 | LAMP 6 5 4 3 2 1 0 |
|---|---|---|---|
| ● | 0 0 0 1 0 0 0 | ● ● ● ● | 1 0 1 0 1 0 1 |
| ● ● | 1 0 0 0 0 0 1 | ● ● ● ● ● | 1 0 1 1 1 0 1 |
| ● ● ● | 0 0 1 1 1 0 0 | ● ● ● ● ● ● | 1 1 1 0 1 1 1 |
合成後の回路規模を確認し、小さい方をチェックして採点ボタンを押してください。
実習で確かめる、つまずきの補足
コードの短さと回路の大きさは別の話
Verilogはプログラムではなく回路の記述だよ。1行にまとめた条件分岐が、合成では何個ものセレクタに展開されることもある。行数が減ったことと、LUTやFFの使用量が減ったことは、別々に確かめる必要があるんだ。条件分岐がどう回路になるかは回路実験1で見られるよ。
冗長な論理を減らして回路を小さくすることを論理圧縮と呼ぶよ。合成ツールは自動で圧縮するけれど、設計者の意図までは読めない。使わない入力の扱いを書かなければ、ツールはその条件でも出力を保てるように回路を作る。だから「どの入力は起こらないのか」「起きたらどうするのか」を仕様として渡すことが、圧縮の前提になるんだ。
ただし、条件を減らせば必ず小さくなるとは限らないよ。面積はデバイス、制約、配置配線の結果にも左右される。比べるときは、同じ機能・同じビット幅・同じ制約・同じデバイスで合成して、LUT・FF・メモリ・遅延のレポートを並べてね。このページの(2)〜(7)は、その比較で差が出やすい書き方を集めたところなんだ。
「どちらでもいい」をコードで伝える方法には落とし穴があるよ。代入を省略することはDon't Careの指定ではなく、組合せ回路では前の値を保つ回路(ラッチ)になる。出力に x を書いて自由度を与える方法もあるけれど、その入力で安全な動作を要求できなくなる。casex は未知値まで一致させてしまう問題があるから、O6の補足とO5の実習を先に見てから選ぼう。